¿Qué es la ingeniería de Reversa? La ingeniería de reversa se podría definir como el arte de analizar un producto para saber cómo fue concebido, y entender su funcionamiento.
Para generar ingeniería de reversa se deben de considerar cuatro pasos fundamentales:
Análisis del producto
Generación de la descripción del producto a un nivel intermedio
Producción de las especificaciones del producto después de un extenso análisis
Generación de un nuevo producto a través de esas especificaciones
¿Por qué hacer ingeniería de Reversa?
Entender los productos de la competencia y desarrollar alternativas
Producir un producto que el proveedor ya no maneja
Tu proveedor ha cerrado sus operaciones
La documentación del producto original se ha perdido y es necesario recuperarla
Actualizar componentes en un producto con tecnología actual
Electronics in Evolution ofrece los servicios de ingeniería de reversa en el área electrónica:
- Obtener un circuito impreso a partir de: Archivo Gerber, Diagramas Esquemáticos, Muestras físicas de Circuitos Impresos
- Obtener diagramas esquemáticos a partir de: Circuitos Impresos, Transferir archivos a plataformas electrónicas CAD, Documentar el diseño y organizarlo electrónicamente en plataformas PCB CAD
INGENIERIA DIRECTA
Ingeniería Directa es cuando primero modelas el software y después lo programas.
Tambien aplica para el Hardware.
O lo que es lo mismo, conectividad abierta de bases de datos. Si escribimos una aplicación para acceder a las tablas de una DB de Access, ¿qué ocurrirá si después queremos que la misma aplicación, y sin reescribir nada, utilice tablas de SQL Server u otra DB cualquiera? La respuesta es sencilla: no funcionará. Nuestra aplicación, diseñada para un motor concreto, no sabrá dialogar con el otro. Evidentemente, si todas las DB funcionaran igual, no tendríamos este problema.... aunque eso no es probable que ocurra nunca.
Pero si hubiera un elemento que por un lado sea siempre igual, y por el otro sea capaz de dialogar con una DB concreta, solo tendríamos que ir cambiando este elemento, y nuestra aplicación siempre funcionaría sin importar lo que hay al otro lado... algo así como ir cambiando las boquillas de una manguera. A esas piezas intercambiables las llamaremos orígenes de datos de ODBC
Casi todas las DB actuales tienen un ODBC. Debido a que este elemento impone ciertas limitaciones, ya que no todo lo que la DB sabe hacer es compatible con la aplicación, como velocidad de proceso, tiempos de espera, máxima longitud de registro, número máximo de registros, versión de SQL, etc., está cayendo en desuso a cambio de otras técnicas de programación, pero aún le quedan muchos años de buen servicio.
Todo lo referido aquí funciona con Windows NT Server 4.0 con el Service Pack 4 o superior instalado (el último publicado es el 6). El Option Pack 4 para actualizar el IIS y las extensiones ASP. SQL Server 6.5 y Access 97. Por supuesto, también funciona con las versiones modernas de servidores como 2003 Server, y también XP PRO, que lleva un IIS 5.0 de serie. Igualmente es posible utilizar bases de datos de Access 2000 o 2003.
Esas otras técnicas de programación antes mencionadas, se utilizan ya en el nuevo Windows 2003, Office 2003 y SQL Server 2000, que además de ODBC pueden utilizar.... pero esa es otra historia.
Esta es la idea: por un lado el ODBC provee de unas caracteríisticas siempre homogéneas, y por el otro permite distintos controladores que aseguran la conectividad de la aplicación con diferentes bases de datos.
Ahora que ya sabemos qué es y para lo que sirve, procedamos a su instalación: es un proceso sencillo, pero según la base de datos elegida sea Access o SQL Server, cambian un poco, y como no podía ser menos, hay algunos trucos que conviene conocer.
CONEXION
Antes de que pueda crear vistas remotas o usar un paso a través de SQL, tiene que instalar un controlador ODBC y configurar el origen de datos ODBC.
Elegir un controlador ODBC
Para instalar los controladores ODBC para estos tipos de datos, use el programa de instalación de Visual FoxPro. Si elige la opción de instalación Completa, se instalan todos los controladores.
Cuando haya elegido un controlador, puede usar el origen de datos predeterminado o agregar un origen de datos ODBC.
Para agregar un origen de datos ODBC
Elija el icono Herramientas administrativas en el Panel de control de Windows.
Elija el acceso directo Orígenes de datos ODBC.
En el cuadro de diálogo Administrador de orígenes de datos ODBC, haga clic en Agregar y, a continuación, seleccione el controlador que desee en la lista Controladores ODBC instalados y elija Aceptar.
En el cuadro de diálogo Configuración de ODBC, establezca los valores de las opciones conforme sea necesario y elija Aceptar.
Para obtener información acerca de cómo configurar un origen de datos específico del controlador elegido, elija el botón Ayuda en el cuadro de diálogo Configuración de ODBC.
Instalar orígenes de datos ODBC
Puede obtener soporte para Conectividad abierta de bases de datos (ODBC) si elige la opción de instalación Completa o Personalizada. Con ODBC, puede tener acceso a un origen de datos SQL Server desde Visual FoxPro; sin embargo, antes de tener acceso al origen de datos, deberá definirlo.
Conexión de Visual FoxPro con los orígenes de datos ODBC
Para definir un origen de datos
Cambie al Panel de control de Windows y elija el icono ODBC.
En el cuadro de diálogo Orígenes de datos, elija Agregar.
En el cuadro de diálogo Agregar origen de datos, seleccione el controlador ODBC SQL Server y elija Aceptar.
En el cuadro de diálogo Instalación de ODBC SQL Server, escriba el nombre, la descripción y cualquier otra información del origen de datos y, a continuación, elija Aceptar.
En el cuadro de diálogo Orígenes de datos, elija Cerrar.
Las herramientas CASE (Computer Aided Software Engineering, Ingeniería de Software Asistida por Computadora) son diversas aplicaciones informáticas destinadas a aumentar la productividad en el desarrollo de software reduciendo el coste de las mismas en términos de tiempo y de dinero. Estas herramientas nos pueden ayudar en todos los aspectos del ciclo de vida de desarrollo del software en tareas como el proceso de realizar un diseño del proyecto, cálculo de costes, implementación de parte del código automáticamente con el diseño dado, compilación automática, documentación o detección de errores entre otras, que analizaba la relación existente entre los requisitos de un problema y las necesidades que éstos generaban, el lenguaje en cuestión se denominaba PSL (Problem Statement Language) y la aplicación que ayudaba a buscar las necesidades de los diseñadores PSA (Problem Statement Analyzer).
Aunque ésos son los inicios de las herramientas informáticas que ayudan a crear nuevos proyectos informáticos, la primera herramienta CASE fue Excelerator que salió a la luz en el año 1984 y trabajaba bajo una plataforma PC.
Las herramientas CASE alcanzaron su techo a principios de los años 90. En la época en la que IBM había conseguido una alianza con la empresa de software AD/Cycle para trabajar con sus mainframes, estos dos gigantes trabajaban con herramientas CASE que abarcaban todo el ciclo de vida del software. Pero poco a poco los mainframes han ido siendo menos utilizados y actualmente el mercado de las Big CASE ha muerto completamente abriendo el mercado de diversas herramientas más específicas para cada fase del ciclo de vida del software.
POWER DESIGNER
PowerDesigner, la herramienta de modelamiento número uno de la industria, permite a las empresas, de manera más fácil, visualizar, analizar y manipular metadatos, logrando un efectiva arquitectura empresarial de información.
PowerDesigner para Arquitectura Empresarial también brinda un enfoque basado en modelos, el cual permite alinear al negocio con la tecnología de información, facilitando la implementación de arquitecturas efectivas de información empresarial. Brinda potentes técnicas de análisis, diseño y gestión de metadatos a la empresa.
PowerDesigner combina varias técnicas estándar de modelamiento con herramientas líder de desarrollo, como .NET, Sybase WorkSpace, Sybase Powerbuilder, Java y Eclipse, para darle a las empresas soluciones de análisis de negocio y de diseño formal de base de datos. Además trabaja con más de 60 bases de datos relacionales.
ERWIN PLATINIUM
PLATINUM ERwin es una herramienta para el diseño de base de datos, que Brinda productividad en su diseño, generación, y mantenimiento de aplicaciones. Desde un modelo lógico de los requerimientos de información, hasta el modelo físico perfeccionado para las características específicas de la base de datos diseñada, además ERwin permite visualizar la estructura, los elementos importantes, y optimizar el diseño de la base de datos. Genera automáticamente las tablas y miles de líneas de stored procedure y triggers para los principales tipos de base de datos. ERwin hace fácil el diseño de una base de datos. Los diseñadores de bases de datos sólo apuntan y pulsan un botón para crear un gráfico del modelo E-R (Entidad _ relación) de todos sus requerimientos de datos y capturar las reglas de negocio en un modelo lógico, mostrando todas las entidades, atributos, relaciones, y llaves importantes. La migración automática garantiza la integridad referencial de la base de datos. ERwin establece una conexión entre una base de datos diseñada y una base de datos, permitiendo transferencia entre ambas y la aplicación de ingeniería reversa. Usando esta conexión, ERwin genera automáticamente tablas, vistas, índices, reglas de integridad referencial (llaves primarias, llaves foráneas), valores por defecto y restricciones de campos y dominios. ERwin soporta principalmente bases de datos relacionales SQL y bases de datos que incluyen Oracle, MicrosoftSQL Server, Sybase. El mismo modelo puede ser usado para generar múltiples bases de datos, o convertir una aplicación de una plataforma de base de datos a otra. Software para Aplicaciones Compatibles: * NetDynamics * PowerBuilder * PROGRESS * Visual Basic Bases de Datos Compatibles: * CA-Clipper * CA-OpenIngres * DB2 for MVS * DB2 for OS/390, * DB2 UDB * dBASE * FoxPro * HiRDB, * Informix * InterBase, * Microsoft Access * Microsoft SQL Server, * Oracle * Paradox, * Rdb * red Brick Warehouse, * SAS * SQL Anywhere, * SQLBase * Sybase, * Teradata Sistemas Operativos Compatibles: * Windows NT * Windows 95 * Windows 98 Requerimientos Técnicos: Mínimo 10 MB de espacio de disco duro, 16 MB RAM (32 MB RAM recomendado para modelos largos.)
La cuarta forma normal, también llamada Forma normal de Boyce Codd (BCNF, Boyce Codd Normal Form), y la quinta forma normal existen, pero rara vez se consideran en un diseño real. Si no se aplican estas reglas, el diseño de la base de datos puede ser menos perfecto, pero no debería afectar a la funcionalidad.
Normalizar una tabla de ejemplo
Estos pasos demuestran el proceso de normalización de una tabla de alumnos ficticia.
Tabla sin normalizar:
Contraer esta tablaAmpliar esta tabla
Nº alumno
Tutor
Despacho-Tut
Clase1
Clase2
Clase3
1022
García
412
101-07
143-01
159-02
4123
Díaz
216
201-01
211-02
214-01
Primera forma normal: no hay grupos repetidos
Las tablas sólo deben tener dos dimensiones. Puesto que un alumno tiene varias clases, estas clases deben aparecer en una tabla independiente. Los campos Clase1, Clase2 y Clase3 de los registros anteriores son indicativos de un problema de diseño.
Las hojas de cálculo suelen usar la tercera dimensión, pero las tablas no deberían hacerlo. Otra forma de considerar ese problema es con una relación de uno a varios y poner el lado de uno y el lado de varios en tablas distintas. En su lugar, cree otra tabla en la primera forma normal eliminando el grupo repetido (Nº clase), según se muestra a continuación:
Contraer esta tablaAmpliar esta tabla
Nº alumno
Tutor
Despacho-Tut
Nº clase
1022
García
412
101-07
1022
García
412
143-01
1022
García
412
159-02
4123
Díaz
216
201-01
4123
Díaz
216
211-02
4123
Díaz
216
214-01
Segunda forma normal: eliminar los datos redundantes
Observe los diversos valores de Nº clase para cada valor de Nº alumno en la tabla anterior. Nº clase no depende funcionalmente de Nº alumno (la clave principal), de modo que la relación no cumple la segunda forma normal.
Las dos tablas siguientes demuestran la segunda forma normal:
Alumnos:
Contraer esta tablaAmpliar esta tabla
Nº alumno
Tutor
Despacho-Tut
1022
García
412
4123
Díaz
216
Registro:
Contraer esta tablaAmpliar esta tabla
Nº alumno
Nº clase
1022
101-07
1022
143-01
1022
159-02
4123
201-01
4123
211-02
4123
214-01
Tercera forma normal: eliminar los datos no dependientes de la clave
En el último ejemplo, Despacho-Tut (el número de despacho del tutor) es funcionalmente dependiente del atributo Tutor. La solución es pasar ese atributo de la tabla Alumnos a la tabla Personal, según se muestra a continuación:
Los valores de un registro que no sean parte de la clave de ese registro no pertenecen a la tabla. En general, siempre que el contenido de un grupo de campos pueda aplicarse a más de un único registro de la tabla, considere colocar estos campos en una tabla independiente. Por ejemplo, en una tabla Contratación de empleados, puede incluirse el nombre de la universidad y la dirección de un candidato. Pero necesita una lista completa de universidades para enviar mensajes de correo electrónico en grupo. Si la información de las universidades se almacena en la tabla Candidatos, no hay forma de enumerar las universidades que no tengan candidatos en ese momento. Cree una tabla Universidades independiente y vincúlela a la tabla Candidatos con el código de universidad como clave.
EXCEPCIÓN: cumplir la tercera forma normal, aunque en teoría es deseable, no siempre es práctico. Si tiene una tabla Clientes y desea eliminar todas las dependencias posibles entre los campos, debe crear tablas independientes para las ciudades, códigos postales, representantes de venta, clases de clientes y cualquier otro factor que pueda estar duplicado en varios registros. En teoría, la normalización merece el trabajo que supone. Sin embargo, muchas tablas pequeñas pueden degradar el rendimiento o superar la capacidad de memoria o de archivos abiertos.
Puede ser más factible aplicar la tercera forma normal sólo a los datos que cambian con frecuencia. Si quedan algunos campos dependientes, diseñe la aplicación para que pida al usuario que compruebe todos los campos relacionados cuando cambie alguno.
Cree tablas independientes para conjuntos de valores que se apliquen a varios registros.
Relacione estas tablas con una clave externa.
Los registros no deben depender de nada que no sea una clave principal de una tabla, una clave compuesta si es necesario. Por ejemplo, considere la dirección de un cliente en un sistema de contabilidad. La dirección se necesita en la tabla Clientes, pero también en las tablas Pedidos, Envíos, Facturas, Cuentas por cobrar y Colecciones. En lugar de almacenar la dirección de un cliente como una entrada independiente en cada una de estas tablas, almacénela en un lugar, ya sea en la tabla Clientes o en una tabla Direcciones independiente.
Elimine los grupos repetidos de las tablas individuales.
Cree una tabla independiente para cada conjunto de datos relacionados.
Identifique cada conjunto de datos relacionados con una clave principal.
No use varios campos en una sola tabla para almacenar datos similares. Por ejemplo, para realizar el seguimiento de un elemento del inventario que proviene de dos orígenes posibles, un registro del inventario puede contener campos para el Código de proveedor 1 y para el Código de proveedor 2.
¿Qué ocurre cuando se agrega un tercer proveedor? Agregar un campo no es la respuesta, requiere modificaciones en las tablas y el programa, y no admite fácilmente un número variable de proveedores. En su lugar, coloque toda la información de los proveedores en una tabla independiente denominada Proveedores y después vincule el inventario a los proveedores con el número de elemento como clave, o los proveedores al inventario con el código de proveedor como clave.
Cuando se utiliza una base de datos para gestionar información, se está plasmando una parte del mundo real en una serie de tablas, registros y campos ubicados en un ordenador; creándose un modelo parcial de la realidad. Antes de crear físicamente estas tablas en el ordenador se debe realizar un modelo de datos.
Se suele cometer el error de ir creando nuevas tablas a medida que se van necesitando, haciendo así el modelo de datos y la construcción física de las tablas simultáneamente. El resultado de esto acaba siendo un sistema de información parcheado, con datos dispersos que terminan por no cumplir adecuadamente los requisitos necesarios.
quedarían como sigue:
¿Cómo se pasa del esquema E/R a las tablas?
Para cada entidad del esquema se creará una tabla con tantos campos como atributos tenga la entidad. Ejemplo:
Tabla 'TRABAJADOR'
DNI
NUM_SS
nombre-apellidos
...
11111111
XXXXXXXXXXX
Fulano de tal
...
22222222
YYYYYYYYYYY
Mengano de cual
...
......
......
......
......
Las relaciones 1-1 se pueden reflejar incluyendo en una de las dos tablas un campo en el que poder colocar la clave del elemento de la otra tabla con el que se está relacionado. Ese nuevo campo que se incluye en la tabla recibe el nombre de clave ajena. Ejemplo:
Tabla 'HOMBRE'
DNI
Nombre
...
11111111
...
...
22222222
...
...
...
...
...
Tabla 'MUJER'
DNI
Nombre
...
DNI-ESPOSO
33333333
...
...
11111111
44444444
...
...
(nulo)
...
...
...
...
Donde el campo DNI-ESPOSO es clave ajena de la tabla HOMBRE. Aquí hay que hacer notar que el campo DNI-ESPOSO puede tomar o bien un valor nulo, en el caso de aquellas mujeres que no estén casadas, o bien el valor de alguno de los DNI de la tabla HOMBRE, en el caso de las mujeres casadas; en este segundo caso, ese DNI (la clave ajena) no se deberá repetir en ningún otro registro de la tabla MUJER.
Las relaciones 1-n se representan de forma muy parecida a como se ha explicado para las relaciones 1-1. La diferencia está en que ahora no es indiferente donde se coloque la clave ajena, esta debe estar obligatoriamente en la tabla del 'mucho' (n); y además, para este caso si se permitirá que haya valores repetidos en dicho campo. Ejemplo:
Tabla 'EMPRESA'
CIF
Nombre
...
XX-1111-AA
...
...
YY-2222-BB
...
...
...
...
...
Tabla 'TRABAJADOR'
DNI
Nombre
...
CIF
11111111
...
...
XX-1111-AA
22222222
...
...
YY-2222-BB
33333333
...
...
YY-2222-BB
44444444
...
...
XX-1111-AA
...
...
...
...
Para representar las relaciones n-n en tablas lo que se hace es crear una nueva tabla solamente para la relación. Esta nueva tabla tendrá dos claves ajenas y su propia clave estará formada por la unión de las claves ajenas. Ejemplo:
Tabla 'ALUMNO'
DNI
Nombre
...
11111111
...
...
22222222
...
...
...
...
...
Tabla 'ASIGNATURA'
COD-ASIGNATURA
Nombre
...
01
...
...
02
...
...
...
...
...
Tabla 'MATRÍCULA'(esta es la relación)
DNI
COD_ASIGNATURA
NOTA
11111111
01
7.5
11111111
02
6.25
22222222
01
5.5
22222222
02
8
...
...
...
En la tabla MATRÍCULA es donde se refleja la relación. La clave de dicha tabla está formada por los campos DNI y COD-ASIGNATURA ; y cada uno de ellos es clave ajena, el primero de ALUMNO y el segundo de ASIGNATURA. Hacer ver aquí que la tabla MATRICULAS puede tener más campos además de los que son clave ajena como ocurre en el ejemplo; la tabla añade además un campo NOTA.
Los atributos, tanto de entidades como de relaciones, toman sus valores posibles de un conjunto llamado dominio. El dominio es, entonces, el conjunto de valores posibles que puede tomar un atributo dado de un conjunto de entidades dado. Por ejemplo, la fecha de nacimiento de una persona puede ser una fecha cualquiera anterior a la fecha actual. El dominio de las fechas de nacimiento, entonces, es el subconjunto de fechas que son anteriores (o iguales, en algunos casos) a la fecha de hoy. El dominio de los números de teléfono, en Chile, podría ser una cadena de caracteres que cumpliera con el formato (XX) XXX-XXXX (simplificado), donde las X son dígitos. En general los dominios serán más bien amplios, aunque cuando se lleva a cabo la implementación es preferible restringir los dominios lo más posible de manera que el gestor de bases de datos automáticamente haga algunas verificaciones sobre los datos que se almacenan, para asegurar la integridad de los datos. Veremos cómo hacer esto en la sección siguiente.
Algunos atributos de un conjunto de entidades son especiales. De partida es necesario definir cuáles de ellos son opcionales y cuáles son obligatorios. Como el nombre lo indica, un atributo obligatorio es aquel que siempre debe estar definido para toda entidad. Un atributo opcional, en cambio, puede quedar sin definir para algunas de las entidades del conjunto de entidades. En general, es deseable que la mayor cantidad de atributos posible se definan como obligatorios, puesto que permite simplificar mucho algunas operaciones, al tiempo que asegura una mejor integridad de los datos. Veremos más sobre esto en la sección siguiente.
Otro concepto importante relacionado con los atributos es el de las llaves. Una superllave de una entidad es un atributo o conjunto de atributos que permite distinguir de modo único cada entidad dentro de un conjunto de entidades. Por ejemplo, el nombre y RUT de una persona sería una superllave. Sólo el nombre no podría serlo, puesto que dos personas pueden tener el mismo nombre. Un conjunto de entidades puede tener más de una superllave; otra superllave para personas podría ser el nombre, la fecha de nacimiento y la dirección postal, puesto que es muy improbable que dos personas hayan nacido el mismo día, vivan en la misma casa y se llamen igual; pero omitiendo cualquiera de esos atributos es razonable esperar encontrar coincidencias.
Además, una superllave puede contener más atributos de los necesarios para identificar unívocamente cada entidad. Eliminando los atributos innecesarios de las superllaves se obtienen las llaves candidatas. Por ejemplo, en el caso del nombre y RUT, usando sólo el RUT serviría también como superllave, y por lo tanto como llave candidata. Observe que todos los atributos que forman una llave candidata son obligatorios, puesto que si falta alguno, no es posible identificar completamente la entidad.
Finalmente, se escoge una de las llaves candidatas y se designa como llave primaria del conjunto de entidades.
Algunos conjuntos de entidades pueden no tener atributos suficientes para formar una llave primaria. En este caso, se dice que es un conjunto de entidades débil. Un ejemplo claro sería un modelo para almacenar facturas de venta de bienes o servicios. Cada factura en sí es una entidad fuerte; cada línea dentro de una factura es una entidad débil, puesto que no se puede identificar una línea en particular sino en tanto pertenece a una factura. Así cada factura tendría una línea número 1, una línea número 2, etc; por lo tanto, hablamos de una línea en particular como la línea número 5 de la factura número 18.289.
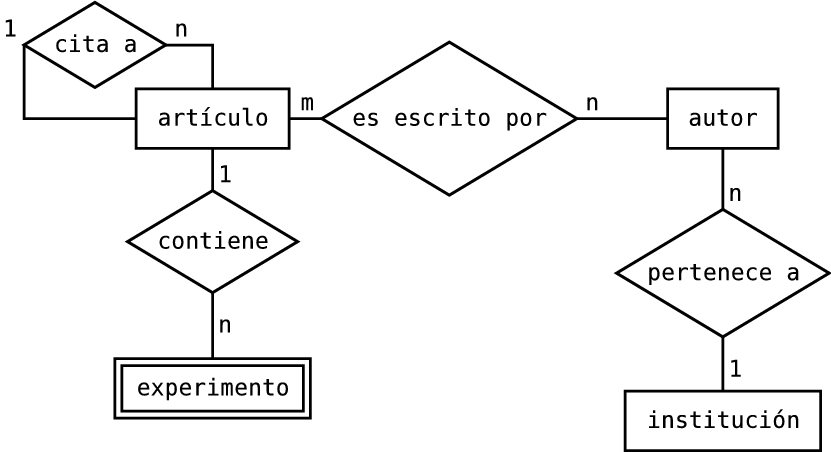
En nuestro ejemplo anterior, todos los conjuntos de entidades son fuertes, puesto que sus elementos cuentan con los atributos suficientes para ser identificados unívocamente. Para ilustrar este nuevo concepto, incluiremos en nuestro modelo los datos de los experimentos que se publican en cada artículo para obtener observaciones sobre las hipótesis que los autores plantean. Cada artículo puede utilizar uno, ninguno o varios experimentos; algunos experimentos serán similares o iguales entre artículos; no hay ningún código asociado intrínsecamente a un experimento, ni modo alguno de distinguirlos de forma unívoca entre todos los artículos. Pero dentro de cada artículo, cada experimento es único. Así, un experimento tendrá un atributo obligatorio que le permitirá ser discriminado de entre el conjunto de experimentos de un mismo artículo (por ejemplo, el número que el mismo autor le asigna en el artículo).
La figura 5 ilustra el nuevo diagrama E-R. Observe que el conjunto de entidades de experimentos se ha marcado como un rectángulo doble, lo cual indica que es débil.
Con respecto a las llaves primarias de nuestro modelo de ejemplo, los conjuntos de entidades fuertes tienen por definición llaves primarias. Sin embargo, en muchos casos estas llaves primarias son complejas de implementar. En el caso de las personas chilenas, usar el RUT es una elección natural. Para personas de otros países, la elección se torna complicada: se podría escoger como llave primaria un número identificador por país en conjunto con el país que emite dicho número. Este esquema puede verse en problemas si existe algún país que no emite números identificadores para sus habitantes. Asimismo, identificar un artículo es complejo: el uso del título no es suficiente, puesto que otro artículo podría llevar el mismo título. Una elección teóricamente mejor sería el uso del resumen como llave primaria, elección que en la práctica es irrisoria cuando menos. Para resolver este problema práctico agregaremos a cada una de estos conjuntos un identificador numérico, ficticio, único dentro de cada conjunto de entidades, independiente de cada uno de los identificadores de los otros conjuntos. Este identificador se generará internamente en la base de datos, y no tendrá ningún significado fuera de ella. Una convención usual es ponerle el nombre del conjunto de entidades, en singular, seguido de id, como en autor_id.
Una interrelación recursiva es una interrelación en la que alguna entidad está asociada más de una vez.
Ejemplo de interrelación recursivaSi, para una entidad persona, queremos tener constancia de qué personas están actualmente casadas entre ellas, será necesario definir la siguiente interrelación, que asocia dos veces la entidad persona:
Una interrelación recursiva puede ser tanto binaria como n-aria
1) Interrelación recursiva binaria: interrelación en la que las ocurrencias asocian dos instancias de la misma entidad*. Las interrelaciones binarias recursivas pueden tener conectividad 1:1, 1:N o M:N, como todas las binarias. En esta interrelación también es posible expresar la dependencia de existencia igual que en el resto de las interrelaciones binarias
Ejemplo de interrelación recursiva binaria
La interrelación boda tiene conectividad 1:1 porque un marido está casado con una sola mujer y una mujer está casada con un solo marido. También tiene un círculo en los dos lados
(según la dependencia de existencia), porque puede haber personas que no estén casadas.
En una interrelación recursiva, puede interesar distinguir los diferentes papeles que una misma entidad tiene en la interrelación. Con este objetivo, se puede etiquetar cada línea de la interrelación con un rol. En las interrelaciones no recursivas normalmente no se especifica el rol; puesto que todas las entidades interrelacionadas son de clases diferentes, sus diferencias de rol se sobreentienden.
Roles diferentes
Una ocurrencia de la interrelación boda asocia a dos personas concretas. Para reflejar el papel diferente que tiene cada una de ellas en la interrelación, una de las personas tendrá el rol de marido y la otra tendrá el rol de mujer.Entidades asociativas
Algunas interrelaciones recursivas no presentan diferenciación de roles; entonces, las líneas de la interrelación no se etiquetan.
No-diferencia de roles
Consideremos una interrelación amistad que asocia a personas concretas que son amigas. A diferencia de lo que sucedía en la interrelación boda, donde una de las personas es el marido y la otra la mujer, en este caso no hay diferenciación de roles entre las dos personas interrelacionadas. A continuación se muestra esta interrelación. Observad que su conectividad es M:N, teniendo en cuenta que una persona puede tener muchos amigos y, al mismo tiempo, puede haber muchas personas que la consideran amiga.
2) Interrelación recursiva n-aria: interrelación recursiva en la que las ocurrencias asocian más de dos instancias.
Ejemplo de interrelación recursiva ternaria
Consideremos una interrelación que registra todas las bodas que se han producido a lo largo del tiempo entre un conjunto de personas determinado. Esta interrelación permite tener constancia no sólo de las bodas vigentes, sino de todas las bodas realizadas en un cierto periodo de tiempo.
Esta interrelación es recursiva y ternaria. Una ocurrencia de la interrelación asocia a una persona que es el marido, a otra que es la mujer y la fecha de su boda. La conectividad es N:1:1.
A los lados del marido y de la mujer les corresponde un 1, porque un marido o una mujer, en una fecha determinada, se casa con una sola persona. Al lado de la entidad fecha le corresponde una N, porque se podría dar el caso de que hubiese, en fechas diferentes, más de una boda entre las mismas personas.
En este subapartado veremos un mecanismo que nos permite considerar una interrelación entre entidades como si fuese una entidad.
La entidad que resulta de considerar una interrelación entre entidades como si fuese una entidad es una entidad asociativa, y tendrá el mismo nombre que la interrelación sobre la que se define.
La utilidad de una entidad asociativa consiste en que se puede interrelacionar con otras entidades y, de forma indirecta, nos permite tener interrelaciones en las que intervienen interrelaciones. Una entidad asociativa se denota recuadrando el rombo de la interrelación de la que proviene.
Ejemplo de entidad asociativa
La figura siguiente muestra un ejemplo de entidad asociativa:
Recorrido es una interrelación de conectividad M:N que registra las ciudades por donde han pasado los diferentes viajes organizados por una empresa de reparto de paquetes. Consideramos recorrido una entidad asociativa con el fin de interrelacionarla con la entidad cliente; de este modo nos será posible reflejar por orden de qué clientes se han hecho repartos en una ciudad del recorrido de un viaje, así como el número de paquetes cargados y descargados siguiendo sus indicaciones.
El mecanismo de las entidades asociativas subsume el de las entidades débiles
y resulta todavía más potente. Es decir, siempre que utilicemos una entidad débil podremos sustituirla por una entidad asociativa, pero no al revés.
Ejemplo de sustitución de una entidad débil por una asociativa
A continuación se muestra la entidad débil despacho, que tiene la interrelación asignación con la entidad empleado.
Podríamos modelizar este caso haciendo que despacho fuese una entidad asociativa si consideramos una nueva entidad número-despacho que contiene simplemente números de despachos. Entonces, la entidad asociativa despacho se obtiene de la interrelación entre edificio ynúmero-despacho.
Aunque las entidades débiles se puedan sustituir por el mecanismo de las entidades asociativas, es adecuado mantenerlas en el modelo ER porque resultan menos complejas y son suficientes para modelizar muchas de las situaciones que se producen en el mundo real
Otra de las características importantes que hay que tener en cuenta en este modelo es la cardinalidad de cada extremo en una relación. La cardinalidad expresa cuántas del conjunto de entidades de un extremo de la relación están relacionadas con cuántas entidades del conjunto del otro extremo. Pueden ser ``uno a uno'', ``uno a varios'' o ``varios a varios''. Por ejemplo, un artículo puede ser escrito por un solo autor o por varios, pero nunca por ninguno; un autor puede pertenecer a exactamente una institución (no para cero o varias); un artículo puede tener cero, uno o varios experimentos. Finalmente, un autor puede escribir muchos artículos, o ninguno. Observe que las cardinalidades en algunos casos dependen de restricciones arbitrarias: se podría decidir aceptar sólo aquellos autores que han escrito al menos un artículo (y con esto cambiaría la última regla mencionada); hemos decidido considerar sólo la institución primaria para la cual un determinado autor trabaja (y esto ha determinado nuestra segunda regla).
Hay varias maneras de mostrar las cardinalidades en el diagrama. Una de ellas es poner etiquetas en las líneas que unen las relaciones con las entidades. La etiqueta consiste de un mínimo y un máximo, cada uno de los cuales contiene un cero, un uno o una letra n (``varios''). Si la cardinalidad es exactamente uno, se pone sólo el uno. En el caso de una relación varios a varios, lo usual es poner una m en un extremo y una n en el otro.
Lo más usual es que las relaciones ocurran entre dos conjuntos de entidades. Esto no es siempre así: en algunos casos puede haber relaciones entre tres o incluso más entidades. Esto no tiene ninguna particularidad teórica; simplemente es una situación peculiar que hay que tener presente que puede existir. Note que si bien es razonable esperar tener relaciones entre tres conjuntos de entidades, cuando surgen relaciones entre cuatro de ellos hay que poner atención al modelo, ya que esto puede indicar alguna debilidad.
Para ilustrar el concepto, supongamos que algunas instituciones otorgan fondos a los autores, para financiar su trabajo en algún artículo. Cada bono de financiamiento se otorga a un autor individual para que trabaje en un artículo; no cubre otros autores del mismo artículo, ni otros artículos del mismo autor. Estos bonos tienen como atributos la fecha en que son entregados y el monto del que consisten. La manera más sencilla de modelar esta situación es incorporar una relación entre autores, artículos e instituciones.
El modelo relacional para la gestión de una base de datos es un modelo de datos basado en la lógica de predicados y en la teoría de conjuntos. Es el modelo más utilizado en la actualidad para modelar problemas reales y administrar datos dinámicamente. Tras ser postuladas sus bases en 1970 por Edgar Frank Codd, de los laboratorios IBM en San José (California), no tardó en consolidarse como un nuevo paradigma en los modelos de base de datos.
Su idea fundamental es el uso de «relaciones». Estas relaciones podrían considerarse en forma lógica como conjuntos de datos llamados «tuplas». Pese a que ésta es la teoría de las bases de datos relacionales creadas por Edgar Frank Codd, la mayoría de las veces se conceptualiza de una manera más fácil de imaginar, esto es, pensando en cada relación como si fuese una tabla que está compuesta por registros (cada fila de la tabla sería un registro o tupla), y columnas (también llamadas campos).
Descripción
En este modelo todos los datos son almacenados en relaciones, y como cada relación es un conjunto de datos, el orden en el que éstos se almacenen no tiene relevancia (a diferencia de otros modelos como el jerárquico y el de red). Esto tiene la considerable ventaja de que es más fácil de entender y de utilizar por un usuario no experto. La información puede ser recuperada o almacenada por medio de consultas que ofrecen una amplia flexibilidad y poder para administrar la información.
Este modelo considera la base de datos como una colección de relaciones. De manera simple, una relación representa una tabla que no es más que un conjunto de filas, cada fila es un conjunto de campos y cada campo representa un valor que interpretado describe el mundo real. Cada fila también se puede denominar tupla o registro y a cada columna también se le puede llamar campo o atributo.
Para manipular la información utilizamos un lenguaje relacional, actualmente se cuenta con dos lenguajes formales el Álgebra relacional y el Cálculo relacional. El Álgebra relacional permite describir la forma de realizar una consulta, en cambio, el Cálculo relacional sólo indica lo que se desea devolver.
Esquema
Un esquema es la definición de una estructura (generalmente relaciones o tablas de una base de datos), es decir, determina la identidad de la relación y que tipo de información podrá ser almacenada dentro de ella; en otras palabras, el esquema son los metadatos de la relación. Todo esquema constará de:
Nombre de la relación (su identificador)
Nombre de los atributos (o campos) de la relación y sus dominios; el dominio de un atributo o campo define los valores permitidos para el mismo, es equivalente al tipo de dato por ejemplo character, integer, date, string, etc.
Instancias
Una instancia de manera formal es la aplicación de un esquema a un conjunto finito de datos. En palabras no tan técnicas, se puede definir como el contenido de una tabla en un momento dado, pero también es valido referirnos a una instancia cuando trabajamos o mostramos únicamente un subconjunto de la información contenida en una relación o tabla, como por ejemplo:
Ciertos caracteres y números (una sola columna de una sola fila).
Algunas o todas las filas con todas o algunas columnas
Cada fila es una tupla. El número de filas es llamado cardinalidad.
El número de columnas es llamado aridad o grado.
Base de datos relacional
Una base de datos relacional es un conjunto de una o más tablas estructuradas en registros (líneas) y campos (columnas), que se vinculan entre sí por un campo en común, en ambos casos posee las mismas características como por ejemplo el nombre de campo, tipo y longitud; a este campo generalmente se le denomina ID, identificador o clave. A esta manera de construir bases de datos se le denomina modelo relacional.
Estrictamente hablando el término se refiere a una colección específica de datos pero a menudo se le usa, en forma errónea como sinónimo del software usado para gestionar esa colección de datos. Ese software se conoce como SGBD (sistema gestor de base de datos) relacional o RDBMS (del inglés relational database management system).
Las bases de datos relacionales pasan por un proceso al que se le conoce como normalización de una base de datos, el cual es entendido como el proceso necesario para que una base de datos sea utilizada de manera óptima.
Entre las ventajas de este modelo están:
Garantiza herramientas para evitar la duplicidad de registros, a través de campos claves o llaves.
Garantiza la integridad referencial: Así al eliminar un registro elimina todos los registros relacionados dependientes.
Favorece la normalización por ser más comprensible y aplicable.
Cuando se utiliza una base de datos para gestionar información, se está plasmando una parte del mundo real en una serie de tablas, registros y campos ubicados en un ordenador; creándose un modelo parcial de la realidad. Antes de crear físicamente estas tablas en el ordenador se debe realizar un modelo de datos
Se suele cometer el error de ir creando nuevas tablas a medida que se van necesitando, haciendo así el modelo de datos y la construcción física de las tablas simultáneamente. El resultado de esto acaba siendo un sistema de información parcheado, con datos dispersos que terminan por no cumplir adecuadamente los requisitos necesarios.
Entidades y Relaciones
El modelo de datos más extendido es el denominado ENTIDAD/RELACIÓN (E/R) En el modelo E/R se parte de una situación real a partir de la cual se definen entidades y relaciones entre dichas entidades:
Entidad.- Objeto del mundo real sobre el que queremos almacenar información (Ej: una persona). Las entidades están compuestas de atributos que son los datos que definen el objeto (para la entidad persona serían DNI, nombre, apellidos, dirección,...). De entre los atributos habrá uno o un conjunto de ellos que no se repite; a este atributo o conjunto de atributos se le llama clave de la entidad, (para la entidad persona una clave seria DNI). En toda entidad siempre hay al menos una clave que en el peor de los casos estará formada por todos los atributos de la tabla. Ya que pueden haber varias claves y necesitamos elegir una, lo haremos atendiendo a estas normas:
Que sea única.
Que se tenga pleno conocimiento de ella.- ¿Por qué en las empresas se asigna a cada cliente un número de cliente?.
Que sea mínima, ya que será muy utilizada por el gestor de base de datos.
Relación.- Asociación entre entidades, sin existencia propia en el mundo real que estamos modelando, pero necesaria para reflejar las interacciones existentes entre entidades. Las relaciones pueden ser de tres tipos:
Relaciones 1-1.- Las entidades que intervienen en la relación se asocian una a una (Ej: la entidad HOMBRE, la entidad MUJER y entre ellos la relación MATRIMONIO).
Relaciones 1-n.- Una ocurrencia de una entidad está asociada con muchas (n) de otra (Ej: la entidad EMPERSA, la entidad TRABAJADOR y entre ellos la relación TRABAJAR-EN).
Relaciones n-n.-Cada ocurrencia, en cualquiera de las dos entidades de la relación, puede estar asociada con muchas (n) de la otra y viceversa (Ej: la entidad ALUMNO, la entidad EMPRESA y entre ellos la relación MATRÍCULA).
Ejemplos
Relación muchos a muchos.
Diseñar el modelo E-R, para la relación Registro de automóvil que consiste en obtener la tarjeta de circulación de un automóvil con los siguientes datos:- Automóvil- Modelo, Placas, Color - Tarjeta de circulación -Propietario, No_serie, Tipo.
Indicamos con este ejemplo que existe una relación de pertenencia de uno a uno, ya que existe una tarjeta de circulación registrada por cada automóvil.
En este ejemplo, representamos que existe un solo presidente para cada país.
Relación muchos a muchos.
El siguiente ejemplo indica que un cliente puede tener muchas cuentas, pero que una cuenta puede llegar a pertenecer a un solo cliente (Decimos puede, ya que existen cuentas registradas a favor de más de una persona).
Es la estructura más utilizada actualmente. En ella los datos están estructurados en tablas:
- Cada fila es un registro o entidad.
- Cada columna es un campo de ese registro.
Esta estructura es similar al concepto matemático de relación, por ello ha tenido tanto auge, ya que todas las teorías y reglas matemáticas sobre relaciones son aplicables, lo que hace que sea fácil de formalizar. A la tabla se le llama relación, y a cada fila tupla; a cada columna de una tupla se le llama atributo, es en esto en lo que se diferencia del modelo matemático.
Los nombres de relaciones siempre en minúsculas.
Cada tupla se puede representar por una variable de tupla.
Cada atributo se representa por su nombre.
Cardinalidad = Nº de tuplas de una relación.
Grado = Nº de atributos de la relación.
Cada atributo puede tomar valores dentro de su dominio de atributo (Conjunto de valores posibles)
El esquema de una relación se representa en letras mayúsculas: r(R) donde r sería el nombre de la relación y R el nombre del esquema.
Formato de un esquema: Nom_esquema=(lista de atributos con sus dominios).
Obsérvese que la primera letra de Alumnos es mayúscula (es un esquema).
Esquema = Definición global y general de una relación.
Instancia de una relación = Información que contiene una relación en un momento determinado.
Claves en el Modelo Relacional
Debe existir un atributo o conjunto de atributos que identifique de un modo único a una tupla; a ese atributo se le llamaría superclave (puede ser el conjunto formado por todos los atributos), al menos hay uno siempre. Para una r(M) diremos que un subconjunto de atributos (K) del esquema será clave de la relación si para toda tupla t1 ≠ t2 se cumple que t1[k] ≠ t2[k] (es decir, dadas dos tuplas diferentes el valor de la clave también lo es). Dentro de las superclaves, llamaremos claves candidatas a las superclaves más pequeñas (aquellas superclaves que carecen de subconjuntos propios que sean también superclaves).De entre todas las que haya, es el usuario el que decide cual es la primaria, las demás se llaman alternativas. Reglas de Integridad:
Integridad de Identidad:La clave primaria de una relación no puede contener valores nulos.
Integridad de Referencia:Cuando en una relación hay un atributo que hace referencia a una clave primaria de otra relación, el atributo debe tener un valor coincidente con alguno de la clave primaria o como mucho ser nulo (es decir, no puede tener un valor que no exista entre los valores de la clave primaria en la primera relación).
Propiedades
Miden su grado de bondad/aproximación al modelo real matemático por una serie de "formas normales", según se sube en las formas se dice que la relación está mejor diseñada. Al menos debe estar en la primera forma normal (1NF) y para ello debe cumplir:
No hay duplicación de tuplas.
No hay orden entre las tuplas.
No hay orden entre los atributos (se accede a través de su nombre).
No existen atributos que no sean atómicos (una casilla un dato). Es decir, no existe la posibilidad de tener una tabla como la siguiente:
Alumno
Asignatura
José
Cálculo
Algebra
Física
no es correcta, sin embargo si lo es esta otra:
Alumno
Asignatura
José
Cálculo
José
Algebra
José
Física
Por último, decir que existe la posibilidad de tratar relaciones entre sí a través de atributos comunes, esto evita la duplicación de la información. Dividimos un esquema en más de uno.
En este caso el campo común entre las relaciones es el campo nº:
Nombre
Núm.
José
15
Antonio
17
Pedro
18
Num.
Asignatura
15
Cálculo
15
Algebra
15
Física
Lenguajes de Consulta a Bases e Datos Relacionales
Los podemos dividir en dos tipos: Lenguajes Formales y Lenguajes Comerciales. Los lenguajes formales están basados en el álgebra relacional o en elcálculo relacional. Solamente se han descrito para consulta a Bases de Datos (existen lenguajes comerciales que además de consulta permiten otras operaciones). El álgebra relacional tiene procedimientos (procedimental), mientras que los lenguajes basados en el cálculo relacional son aprocedimentales. Dentro del cálculo relacional se distingue entre cálculo relacional orientado a tuplas y cálculo relacional orientado a dominios. Los lenguajes comerciales, en su mayoría usan enfoques tanto procedimentales como aprocedimentales, o lo que es lo mismo, no son lenguajes puros como los formales. De esta manera hacen su sintaxis más amigable al usuario.